
主题
零门槛上手:在算力自由平台一键训练并可视化 MicroDuck 四足机器人
本教程面向算力自由平台用户。无需购买实体机器人、无需手动配置环境、无需具备强化学习基础。只需在平台开通一台 GPU 实例,执行一条安装命令,即可通过远程桌面直观看到小鸭子从摔得四脚朝天,逐步学会站稳、走直线、坐下起立,甚至完成踢球动作。
准备:在算力自由平台上开通一台 GPU 实例
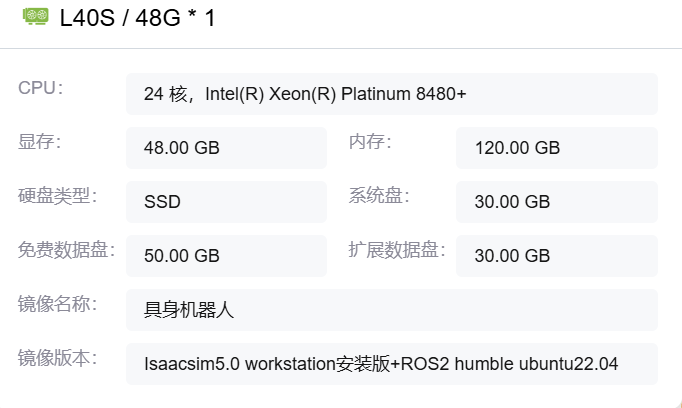
- 创建实例:登录算力自由控制台,创建一台带 NVIDIA GPU 的实例。实测训练 4096 个并行环境只占约 6 GB 显存,机型选择很宽松(L40S / 4090 都可以);数据盘建议 50 GB 左右(训练环境约 8 GB,外加模型 checkpoint 和日志)。
- 登录方式:纯训练用 SSH 登录即可;要亲眼看到仿真画面,需要平台的远程桌面 / 图形界面入口——镜像里已带好 XFCE 桌面。
- 镜像内容:实例启动后 MicroDuck 应用已在
/opt/microduck/app-v1.3/,离线环境包在/opt/microduck/bundles/,无需再下载任何东西。
一、运行环境与依赖
系统与硬件:Ubuntu 22.04 LTS(x86_64,内核 5.15),NVIDIA L40S 48 GB(驱动 580.126.09,计算能力 8.9),224 核 CPU / 1007 GB 内存,图形桌面 Xorg :20 + XFCE4。
框架与库:Python 3.12.11,PyTorch 2.9.1(CUDA 12.8 构建),MuJoCo 3.10.0 + MuJoCo Warp 3.8.1 + warp-lang 1.12.0(GPU 并行物理仿真),mjlab 1.3.0(训练框架),RSL-RL 5.0.1(PPO 实现),Better Actuator Models 1.0.1(舵机扩展摩擦建模),ONNX 1.22.0 / ONNX Runtime 1.24.4(策略导出),TensorBoard 2.20.0(曲线),FFmpeg 4.4.2(回放视频)。依赖由 uv 锁定,共 142 个包。
一键配置:进入应用目录执行 bash install.sh,自动完成前置检查、环境展开、路径登记与五项实测;加 --train <课程ID> 可在装完后直接后台开训,加 --smoke 先跑链路试跑。完整依赖清单见仓库 docs/ENVIRONMENT.md。
代码结构
应用目录 /opt/microduck/app-v1.3/:
text
├── duck                    # 顶层入口,转发到 scripts/duck.sh
├── install.sh              # 一键安装脚本(六步:检查→判路→环境→路径→实测→用法)
├── scripts/
│   ├── duck.sh             # 命令分发器,选择 Python ≥3.10 后转发到 CLI
│   ├── duck_cli.py         # 全部子命令:init / check / demo / quick / train
│   │                       #   / resume / results / result / retry / simulate
│   │                       #   / fusion / shortcuts / courses / config
│   ├── duck_menu.py        # 交互仿真启动台(按中文课程名直接开窗)
│   └── course_runtime.py   # GPU 侧回放与评估运行时
├── ui/
│   ├── pipeline.py         # 课程流水线:主机级互斥锁 + 阶段执行(可取消)
│   ├── server.py           # 本地工作台:实验记录读写、状态管理
│   ├── courses.py          # 课程注册表 PROFILES:课程 ↔ 上游任务映射
│   └── offline_runtime.py  # 离线包校验与首启展开
├── config/
│   ├── training.lock.json  # 上游仓库版本锁(固定 commit)
│   └── offline-image.json  # 离线镜像清单
├── docs/                   # 手册与验收记录
└── .state/ # 运行状态与路径登记关键训练路径
① 训练环境
位置:/root/gpufree-data/Microduck/Microduck/external/microduck_rl/.venv
说明:install.sh / duck init 自动展开的 Python 环境,约 8 GB,
装了 PyTorch、MuJoCo、mjlab、RSL-RL 等全部 142 个依赖包。勿手动删除。
② 训练产物(模型)
位置:/root/gpufree-data/Microduck/Microduck/external/microduck_rl/logs/rsl_rl/microduck_ui/
说明:训练出的模型都存在这里,包括每 1000 轮保存的 checkpoint(model_*.pt)、 训练完导出的 ONNX 策略、TensorBoard 曲线数据文件。
③ 实验记录与训练日志
位置:/root/gpufree-data/microduck-runs/ui/<实验ID>/
说明:每次训练自动生成一条记录,包括 job.json(本次训练的参数与状态)
和 console.log(训练曲线日志,看训练进度和指标就是看这个文件)。
⚠️ 注意:系统盘(30 GB)只放镜像本体;以上三个路径都在数据盘上。
释放实例前,记得备份数据盘里的模型。
二、训练验证与试跑
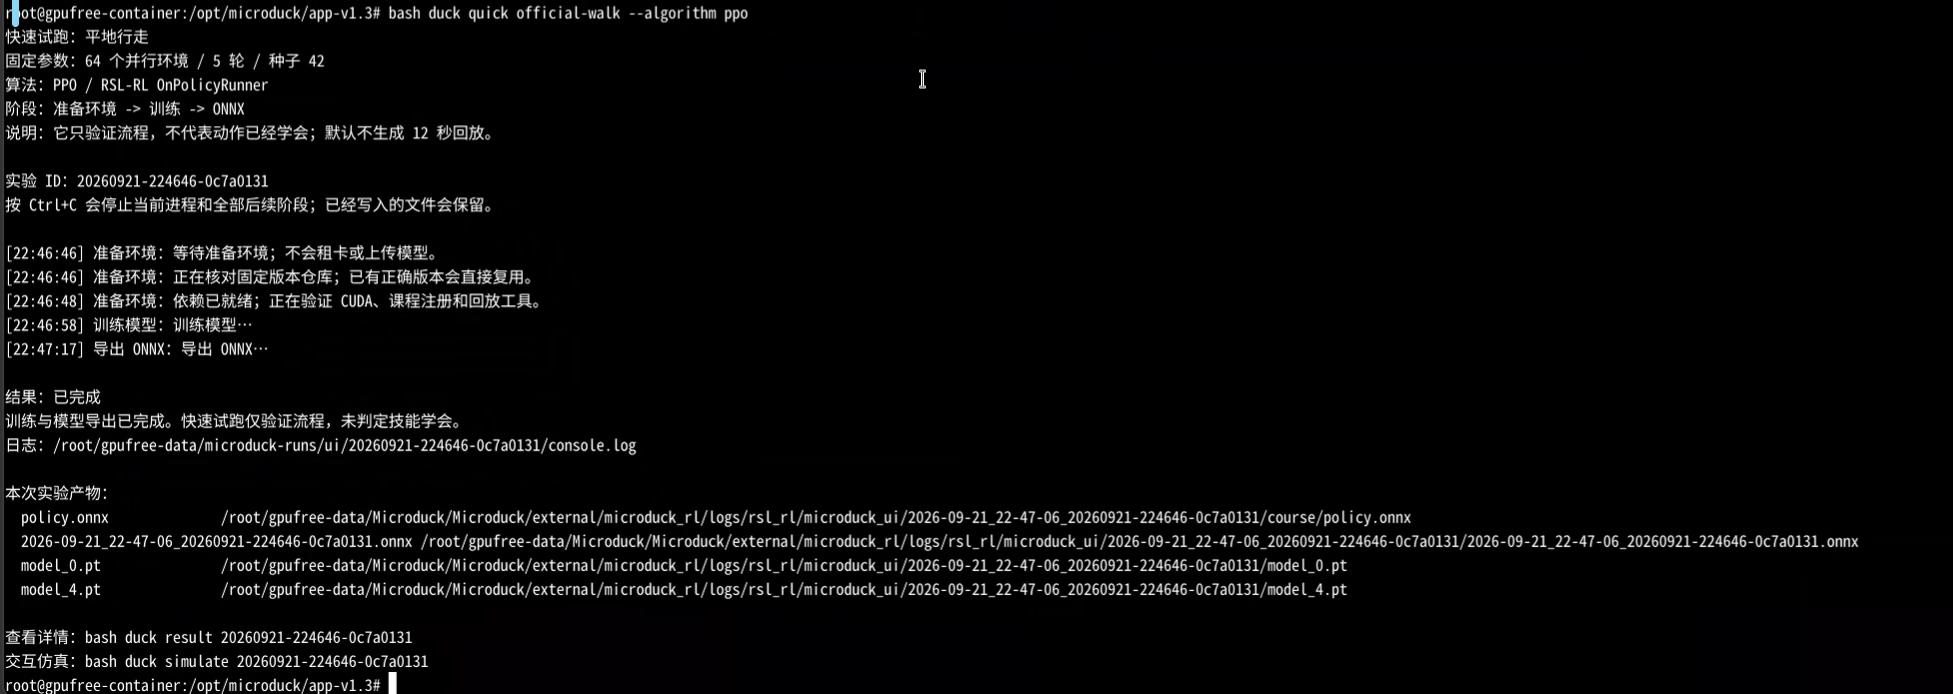
2.1 试跑(平地行走完整流程)
bash
cd /opt/microduck/app-v1.3
bash duck quick official-walk --algorithm ppo- 关键参数:64 个并行环境、5 轮迭代、PPO 算法。
- 预期表现:数分钟内完成「准备 → 训练 → 存 checkpoint → 导出 ONNX」全流程;初期大量摔倒是正常现象——试跑只验证链路,不代表学会动作。
- 产物:模型 checkpoint 与 ONNX(含观测归一化参数)。
试跑完成的终端输出
2.2 六门课程
每门课程一条独立记录:训练目标、环境配置、核心参数,下附演示。
课程 1 · 平地行走(official-walk)
bash duck sim 平地行走- 训练目标:跟踪速度命令,交替步态,支持转向与刹停。
- 环境配置:平地场景,twist 速度命令(含转向与原地转身采样)。
- 核心参数:4096 环境 / 约 5000 轮 / PPO / 每轮 24 步 / 随机种子 42。
- 方向键加速→ 转弯 → 刹停 完整视频:平地行走_video.mp4。
课程 2 · 起立(official-standup)
bash duck sim 起立- 训练目标:从任务规定的初始姿态起立(非任意跌倒恢复)。
- 环境配置:平地场景,规定初始姿态,含推力扰动评估。
- 核心参数:4096 环境 / 约 5000 轮 / PPO。
- 起立过程,中途施加随机推力观察稳定性。
完整视频:起立_video.mp4。
课程 3 · 坐站切换(official-sitstand)
bash duck sim 坐站切换- 训练目标:响应坐下 / 站起命令,过渡平顺。
- 环境配置:平地场景,坐/站目标每 4 秒交替,目标渐变。
- 核心参数:4096 环境 / 约 1000 轮 / PPO。
- 按
Y键来回切换,每次等动作完整结束。
完整视频:坐站切换_video.mp4。
课程 4 · 地面动作(official-ground-pick)
bash duck sim 地面动作- 训练目标:低头接近地面再回到站姿的分阶段动作(非抓取物体)。
- 环境配置:平地场景,分阶段课程调度。
- 核心参数:4096 环境 / 约 1000 轮 / PPO。
- 按
G键,低头接近地面再恢复站姿。
完整视频:地面动作_video.mp4。
课程 5 · 踢球(official-ball-kick)
bash duck sim 踢球- 训练目标:在带球与接触物理的场景中踢球,球产生实际位移。
- 环境配置:平地场景,含球与接触物理。
- 核心参数:4096 环境 / 约 1000 轮 / PPO。
- 按
K/L键左右脚踢。
完整视频:踢球_video.mp4。
课程 6 · 轮滑(official-rollers)
bash duck sim 轮滑- 训练目标:被动轮式模型的直线滑行速度跟踪与加减速控制。本课程不含转向(上游将转向命令采样范围设为 0,并奖励保持初始朝向)。
- 环境配置:轮式机器人模型,直线速度命令。
- 核心参数:4096 环境 / 约 5000 轮 / PPO。
- 直线加速 → 匀速滑行 → 减速停下
完整视频:轮滑_video.mp4。
补充说明:以上轮数为 4096 环境下的建议训练量(见第四节收敛分析)。训练命令示例:
bash duck train <课程ID> --envs 4096 --iterations <轮数> --replay
三、训练策略与算法
算法选型:PPO(近端策略优化),RSL-RL 5.0.1 实现;Actor-Critic 均为 MLP(512, 256, 128)+ ELU,开观测归一化。
核心机制:
- On-policy 更新——每轮采集的数据只更新一次即丢弃,更新保守(clip 0.2),步子小不崩。
- 自适应学习率——每轮计算新旧策略 KL 散度,偏离目标 0.01 自动调整,环境数变化有自我补偿。
- 位置控制动作——策略输出关节目标角度而非力矩,与真机舵机控制方式一致,缩小 sim2real 差距。
- 带噪观测——61 维观测(角速度、重力方向、关节角/角速度、命令)刻意注入噪声与延迟,防止策略过拟合干净仿真。
- 课程学习——难度分级放:站立命令占比 2%→25%,罚项权重分段加大,速度范围逐步放宽。
- 域随机化——质心、质量惯量、关节摩擦(BAM 每环境独立摩擦预算)、噪声、延迟、齿隙随机化,提升真机迁移鲁棒性。
关键超参:
| 超参 | 值 | 超参 | 值 |
|---|---|---|---|
| clip_param | 0.2 | learning_rate | 1e-3(adaptive,KL=0.01) |
| entropy_coef | 0.01 | gamma / lam | 0.99 / 0.95 |
| learning_epochs | 5 | num_mini_batches | 4 |
| steps_per_env | 24 | 单轮样本量 | envs × 24(4096 时约 9.8 万步) |
| 网络 | MLP (512,256,128) ELU | 观测 / 动作维度 | 61 / 关节目标角度 |
四、训练曲线与效果评估
4.1 控制台查看
bash
cd /opt/microduck/app-v1.3
LOG=$(ls -t /root/gpufree-data/microduck-runs/ui/*/console.log | head -1)
tail -f "$LOG"                                                  # 实时跟踪
tail -n 80 "$LOG" | grep -E "Iteration|Reward/|fell_over|ETA" # 关键指标4.2 指标呈现
| 指标 | 含义 | 健康标准 |
|---|---|---|
主任务奖励(如 wheel_speed、速度跟踪项) | 任务完成度 | 持续上升 |
Episode_Termination/fell_over | 摔倒比例(稳定性) | 持续下降 |
Metrics/twist/error_vel_xy | 速度跟踪误差 | 趋近于 0 |
Episode_Termination/time_out | 回合存活时长 | 上升 |
| 罚项奖励 | 动作质量约束 | 保持为负;为正说明奖励定义有误 |
Iteration time / ETA | 训练吞吐与剩余时间 | 参考排期用 |
关键节点快照(轮滑课程第 30,547 轮,真实日志):
text
Episode_Reward/wheel_speed:      0.9233    ← 主任务奖励,已高位
Episode_Reward/heading_hold:     0.3388
Curriculum/action_rate_weight:  -2.0000    ← 课程已进入高罚项阶段
Metrics/twist/error_vel_xy:      0.0000    ← 速度跟踪误差收敛
Episode_Termination/fell_over:   0.2083    ← 摔倒比例处于低位
Iteration time: 1.48s4.3 收敛情况与对比结论
收敛节点:4096 环境下,步态类课程在 4,000~6,000 轮、动作类课程在约 1,000 轮达到可用水平;此后主奖励进入高位平台期,继续训练收益边际递减(轮滑训至 30,000 轮时 wheel_speed 奖励 0.92,增长已趋平)。平地行走约 5,000 轮即达到演示可用。
对比结论:
- 按预算训练 vs 按上限训练:课程表中的
max_iterations(如 50,000)是上限非目标,按预算训练可节省约 90% 时间且效果等价。 - 单任务 vs 三任务并行(同卡实测):三任务并行总吞吐仅提升约 11%,但单任务每轮耗时从 1.6 s 升至 4.3 s(慢 2.7 倍)——单卡不值得并行,应顺序执行或增加实例。
- 稳定性:自适应学习率下训练过程未出现策略崩溃;罚项权重随课程动态调整期间指标波动属正常。
五、新增训练任务
上游共 45 个已注册任务(.venv/bin/list-envs 可查看),当前镜像封装并验收 6 门。以下任务值得扩展,均基于现有框架:
| 任务 ID | GitHub 仓库 | 核心特性 | 与本项目的适配点 |
|---|---|---|---|
Mjlab-Velocity-Rough-MicroDuck | pollen-robotics/microduck_rl | 粗糙地形速度跟踪 | 复用平地行走步态注册,直接对比地形泛化 |
Mjlab-VelStand-Flat-MicroDuck | pollen-robotics/microduck_rl | 行走 + 跌倒恢复单策略 | 比起立更实用,验收标准更高 |
Mjlab-Velocity-Swizzle-MicroDuck | pollen-robotics/microduck_rl | 对称摆滑(转向已开启) | 为轮滑补转向的入口任务 |
Mjlab-Spin-Flat-MicroDuck | pollen-robotics/microduck_rl | 轮上原地旋转 | 纯转向能力,与轮滑互补 |
Mjlab-Roulade-Flat-MicroDuck | pollen-robotics/microduck_rl | 前滚翻后落回双脚 | 高难度展示动作 |
Mjlab-RollerCrouch-Flat-MicroDuck | pollen-robotics/microduck_rl | 滑行中下蹲 | 轮滑进阶变体 |
Mjlab-Velocity-Flat-Backlash-MicroDuck | pollen-robotics/microduck_rl | 带齿隙仿真的行走 | 消融对照实验素材 |
| Unitree G1 / Go1 等通用任务 | mujocolab/mjlab | Isaac Lab 式 API + MuJoCo Warp,内置多机器人 | 验证框架跨机器人迁移能力 |
| 冲刺跑 / 节拍舞蹈 | emwstudio/DuckEMW | 独立环境,速度评估与节拍动作 | 课程定义已保留,源码未封装进镜像 |
| PPO 后端 | leggedrobotics/rsl_rl | 策略梯度算法库 | 算法层依赖,已锁定 5.0.1 |
| 执行器摩擦建模(BAM) | Rhoban/bam | 舵机扩展摩擦模型(Stribeck / 负载 / 二次项),含 XL330 实测模型库 | sim2real 关键组件,已随镜像 vendored |
加课流程:① 在 ui/courses.py 的 PROFILES 注册课程(ID、上游任务、默认轮数、验收标准);② 在 config/training.lock.json 固定对应上游 commit(禁用浮动分支);③ 执行 doctor → quick → train → simulate 完整验收并留存动作证据。仅跑通且人工确认动作合格的任务才写入课程表。